IRONSTICK — Déclaration RGPD des flux de données
Relations avec les grands modèles de langage externes
Description factuelle, établie à partir du code, de chacune des voies par
lesquelles des données quittent IRONSTICK en direction d'un LLM externe, de ce qui est
exactement transmis, sous quelle forme, et des points où s'applique la couche de
pseudonymisation. Édition de bureau Windows. Le présent document décrit
exclusivement le comportement d'IRONSTICK — ce que le fournisseur d'IA fait des
données reçues est régi exclusivement par les conditions propres au fournisseur
(les conditions et politiques de confidentialité des fournisseurs que l'utilisateur a
configurés — Google, Alibaba Cloud, Moonshot AI, OpenAI et/ou Anthropic), que
l'utilisateur doit examiner séparément.
1. Périmètre et points de terminaison
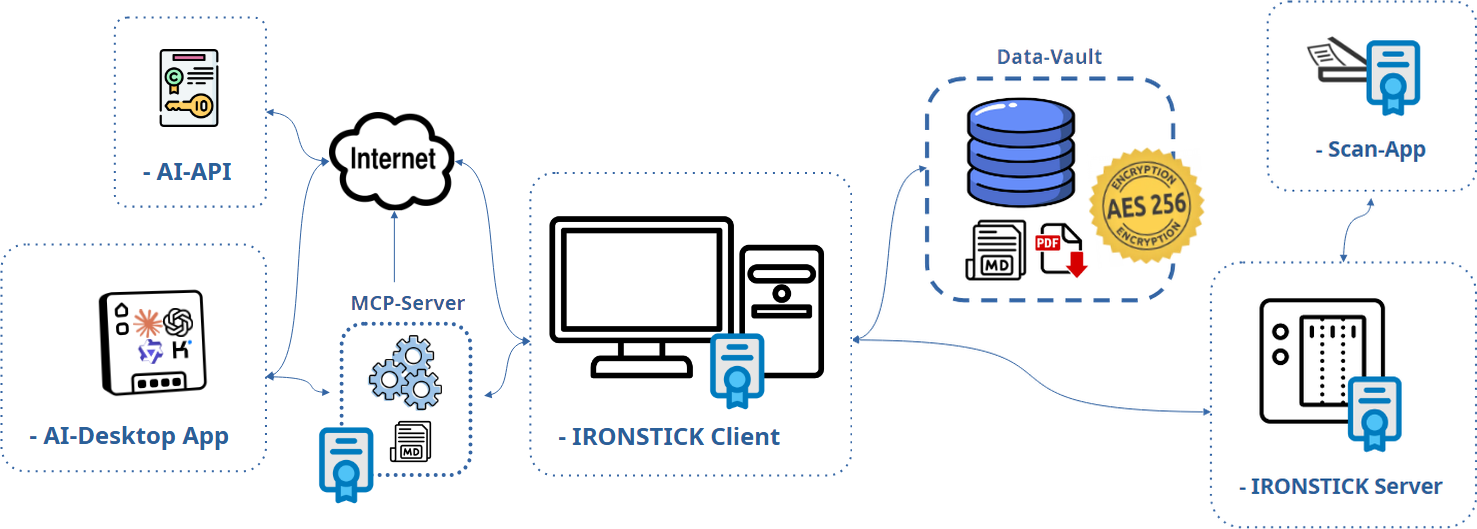
Les appels d'IA externes effectués depuis l'application sont adressés au
fournisseur que la cascade automatique utilise à ce moment-là. L'utilisateur peut
configurer jusqu'à cinq fournisseurs ; chaque fournisseur configuré est utilisé
automatiquement dans l'ordre fixe suivant, conçu pour réduire les coûts :
Gemini (Google) → Qwen (Alibaba Cloud) → Kimi (Moonshot AI) →
ChatGPT (OpenAI) → Claude (Anthropic). À chaque démarrage du programme, IRONSTICK
vérifie lesquels d'entre eux répondent ; si un quota ou un crédit est épuisé au cours
de la journée, ou si un fournisseur cesse de répondre, la même requête est répétée
auprès du fournisseur suivant, qui est alors utilisé pour le reste de la journée. Le
contenu transmis est identique pour chaque fournisseur (à partir de la section 3 :
pseudonymisé par le routeur, consentement, journal d'audit). Les points de
terminaison sont les suivants :
- Claude :
POST https://api.anthropic.com/v1/messages,
clé API propre de l'utilisateur.
- ChatGPT :
POST https://api.openai.com/v1/chat/completions,
clé API propre de l'utilisateur.
- Qwen :
POST https://dashscope-intl.aliyuncs.com/compatible-mode/v1/chat/completions
(Alibaba Cloud Model Studio, région internationale), clé API propre de l'utilisateur.
- Kimi :
POST https://api.moonshot.ai/v1/chat/completions
(Moonshot AI), clé API propre de l'utilisateur.
- Gemini (Windows uniquement) : aucune clé API. IRONSTICK pilote le client en
ligne de commande propre à Google, non modifié (Google Antigravity CLI), en tant que
processus local masqué ; le client est connecté avec le compte Google de
l'utilisateur (boîte de dialogue de connexion propre à Google — IRONSTICK ne voit
jamais ni le mot de passe ni le code) et envoie la requête à Google dans le cadre de
l'abonnement Google AI de l'utilisateur. Le client n'a aucun accès aux outils ni aux
fichiers d'IRONSTICK ; il s'exécute dans un dossier de travail vide, avec un dossier
de profil privé situé dans le répertoire de données, et ses enregistrements locaux de
conversation et journaux sont supprimés après chaque appel.
Gemini via un compte Google est un service grand public, et
non un canal de sous-traitance. Selon les conditions de Google Antigravity, Google
peut utiliser les interactions pour améliorer ses produits et ses technologies
d'apprentissage automatique, et le personnel de Google peut les examiner, à moins que
l'utilisateur ne désactive cette option dans les paramètres de Google Antigravity ; il
n'existe aucun contrat de sous-traitance pour cette voie. IRONSTICK transmet le même
contenu pseudonymisé que sur les voies API, mais un cabinet dont les règles
professionnelles exigent un contrat de sous-traitance pour chaque sous-traitant ne
devrait pas configurer Gemini — un fournisseur qui n'est pas configuré n'est jamais
utilisé par la cascade.
Trois niveaux de modèle configurables sont utilisés par fournisseur (petit / moyen /
grand). Un canal distinct et facultatif est la
passerelle d'IA de bureau (section 4.9) : dans ce cas, les données sont
transmises à l'IA de bureau locale propre de l'utilisateur (Claude Desktop / Claude
Code, ChatGPT Desktop, Qwen Desktop ou Kimi Desktop), c'est-à-dire au
fournisseur de cette IA (Anthropic, OpenAI, Alibaba Cloud/Qwen ou Moonshot AI/Kimi),
dans le cadre de l'abonnement/du compte propre de l'utilisateur auprès de ce
fournisseur. Les
passerelles peuvent fonctionner en parallèle — le même serveur MCP local peut être
enregistré simultanément auprès de Claude, ChatGPT, Qwen et Kimi, et ceux-ci peuvent
travailler en même temps sur le même dossier. IRONSTICK n'exploite aucun serveur
propre ; aucune donnée n'est jamais transmise à l'éditeur du logiciel. Le serveur LAN
du cabinet, facultatif (IRONSTICK SERVER, section 9), n'y change rien : il est
exploité par le cabinet lui-même, sur le matériel propre du cabinet, au sein du réseau
propre du cabinet — il ne contacte jamais l'éditeur ni aucun fournisseur d'IA.
L'interrupteur principal est l'accès propre de l'utilisateur.
Un traitement d'IA externe depuis l'application n'existe que si l'utilisateur a ouvert
son propre compte auprès d'un fournisseur d'IA et saisi sa propre clé d'accès dans la
configuration (pour Gemini : s'est connecté avec son compte Google).
Si aucun fournisseur n'est configuré, aucun appel d'IA externe depuis l'application
ne peut avoir lieu — chacune des fonctionnalités décrites à la section 4 reste
alors locale ou est tout simplement indisponible. Ce compte constitue un contrat
direct entre l'utilisateur et le fournisseur ; IRONSTICK n'y est pas partie. Il en va
de même pour la passerelle d'IA de bureau, qui requiert l'abonnement/le compte propre
de l'utilisateur auprès du fournisseur d'IA de bureau choisi (Anthropic, OpenAI,
Alibaba Cloud/Qwen ou Moonshot AI/Kimi). Les documents marqués comme secrets
sont exclus des outils de la passerelle et du chat, du paquet d'instructions IA et de
toute sortie générée (pièces jointes, dossiers, exports) ; leur traitement lors de la
saisie suit le choix délibéré de l'utilisateur au moment de la saisie
(section 4.1).
Entièrement local (rien ne quitte la machine) : extraction de texte et OCR, la
couche de chat locale déterministe, la recherche globale, le radar de pertinence,
l'analyse des chaînes de courriers, la génération de dossiers/PDF, la passe locale de
l'outil de repérage pour le caviardage, ainsi que la constitution du paquet
d'instructions IA.
2. La couche de pseudonymisation
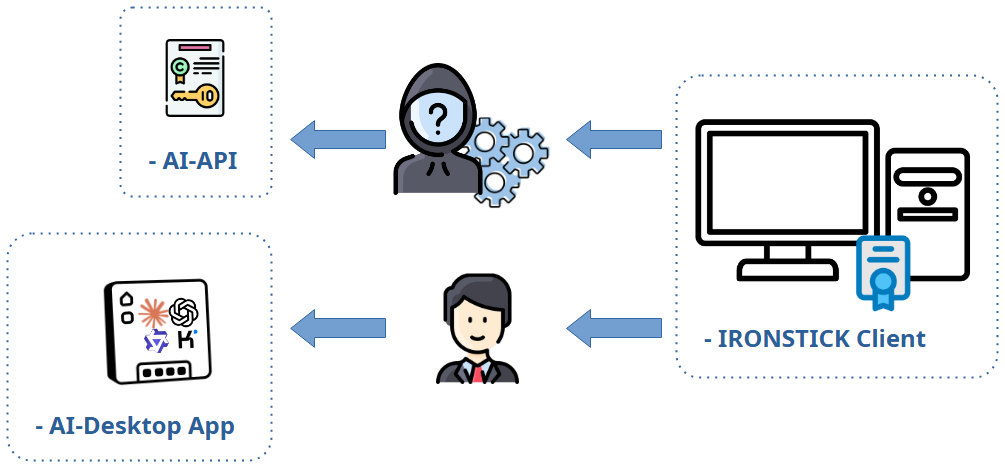
Chaque exécution d'agent au sein de l'application peut comporter un pseudonymiseur
qui remplace par des jetons le texte sortant, retraduit les arguments des outils pour
leur exécution locale, remplace de nouveau par des jetons les résultats des outils et
rétablit localement les valeurs dans la réponse finale. La table de correspondance
n'existe qu'en mémoire, une nouvelle table par opération ; elle n'est jamais
enregistrée de manière persistante.
2.1 Ce qui est remplacé
| Source | Champs | Jeton |
|---|
| Fiches clients | nom, CNP, téléphone, courriel, adresse+ville |
$PARTEI_A$, $CNP_A$, $TEL_A$, $MAIL_A$, $ADRESSE_A$ |
| Personnes / entités | nom complet (personne ou société), CNP |
$PARTEI_B$ / $FIRMA_A$, $CNP_B$ |
| Dossiers | numéro de dossier, partie adverse, demandeur |
$FALL_A$, $PARTEI_C$… |
| Couche de motifs (valeurs inconnues dans le texte libre) |
numéros de dossier judiciaire (n/nnn/yyyy), CNP à 13 chiffres, IBAN, adresses
électroniques, numéros de téléphone plausibles | mêmes familles de jetons |
2.2 Ce qui reste délibérément réel
- Dates, heures et montants — leur falsification a été jugée plus dangereuse
que leur transmission.
- Noms d'institutions (juridictions, autorités) — ils ne figurent pas dans le
dictionnaire et sont des organismes publics.
- Tiers inconnus dans le texte libre — les témoins, médecins, avocats,
juges ou sociétés qui ne sont pas enregistrés en tant que fiches client/personne/dossier
ne sont pas reconnus et sont transmis en clair. Il s'agit d'une limite documentée de
l'approche.
- Adresses de non-clients — il n'existe aucun motif d'adresse ; seule
l'adresse enregistrée du client est remplacée par un jeton.
- L'intégralité du contenu factuel des documents (allégations, diagnostics,
récit) — seuls les identifiants sont remplacés, non l'histoire.
2.3 Exceptions délibérées de noms en clair
- Recherche web sur des personnes (étape 1) et remplissage automatique de
formulaires pour les personnes / institutions : une recherche web portant sur
$PARTEI_A$ n'a aucun sens ; le nom réel est donc envoyé par conception.
- Outil d'IA de repérage pour le caviardage : il reçoit un texte déjà caviardé
localement et doit répondre en indiquant les noms en clair des tiers inconnus
qu'il trouve — la pseudonymisation est désactivée pour cette seule finalité.
- Prétraitement de la lecture à voix haute (TTS) : voir 4.6 — les phrases sont
transmises en clair.
- Passerelle d'IA de bureau : données brutes par conception (section 4.9).
3. Moments de consentement et journal d'audit
Les appels acheminés par le routeur central sont soumis au consentement et
journalisés : chaque tour de modèle inscrit une ligne dans la table d'audit locale
(T0_AiExtLog) contenant la requête et la réponse complètes sous la
forme remplacée par des jetons qui a effectivement quitté la machine ; les
tentatives refusées/bloquées sont journalisées sans contenu. La boîte de dialogue de
consentement indique le niveau de modèle et la taille approximative de la requête, et
une seule approbation couvre la session d'écran en cours (pour la saisie de
documents : l'exécution en cours du programme).
Flux à consentement automatique (sans boîte de dialogue) :
le tri des courriels en arrière-plan (fonctionnement continu), l'exécution d'analyse
du moniteur de données et l'outil d'IA de repérage pour le caviardage (l'activation
de son interrupteur vaut consentement). Ces flux restent pseudonymisés (à l'exception
des réponses en noms en clair voulues de l'outil de repérage pour le caviardage) et
restent audités.
Flux qui contournent le routeur : les fonctions d'IA du
traitement de texte, le prétraitement de la lecture à voix haute et l'appel de
correction par IA File→Markdown appellent directement l'API. Ils sont pseudonymisés
(exception : lecture à voix haute), mais ils n'affichent aucune boîte de dialogue
de consentement propre et n'inscrivent aucune ligne dans le journal
d'audit. L'utilisation de ces fonctionnalités par l'utilisateur (appui sur le
bouton IA, lancement d'une génération, lancement de la lecture à voix haute avec
l'interrupteur IA activé) constitue le moment du consentement.
4. Les flux de données, cas d'usage par cas d'usage
4.1 Saisie de documents
L'extraction de texte et l'OCR sont locales. Si une clé API est configurée,
IRONSTICK demande l'autorisation une fois par exécution du programme, puis jusqu'à
quatre types d'appels sont effectués (tous pseudonymisés, tous audités) :
- Détection du document principal (petit niveau) : texte OCR brut, par
tranches d'au plus 2 000 caractères, 8 appels au maximum — uniquement pour les
numérisations de mauvaise qualité.
- Correction de l'OCR (petit niveau) : texte du document plafonné à
16 000 caractères.
- Classification (niveau moyen) : texte du document plafonné à 16 000
caractères, plus des listes système : la liste complète des dossiers (numéro
de dossier, nom du client, partie adverse — remplacés par des jetons), un ensemble
de noms connus plafonné à 2 000 caractères (remplacés par des jetons), ainsi que les
listes de codes des types d'institutions et des types de documents (libellés non
remplacés par des jetons). Solution de repli : petit niveau, 8 000 caractères, sans
les listes.
- Contextualisation lors de l'enregistrement (petit niveau) : les
métadonnées du document et son texte intégral plafonné à 30 000 caractères, plus une
ligne d'index (ID, date, titre ≤120 caractères) de chaque pièce active du même
client — utilisée pour étayer les renvois. S'exécute également pour les
documents marqués comme secrets (décision délibérée de l'utilisateur).
4.2 Moniteur de courriels (tri)
L'affectation à un dossier est d'abord déterministe (numéro de dossier ou numéro
de rôle connu trouvé dans l'objet/l'extrait — aucun appel d'IA). À défaut, un
appel de petit niveau par courriel transmet exactement : le nom et l'adresse de
l'expéditeur, l'objet et l'extrait d'aperçu enregistré (plafonné strictement à 1 500
caractères) — jamais le corps complet —, plus la liste complète des dossiers
(remplacée par des jetons) comme contexte de correspondance. Réponse : priorité +
numéro de dossier. Dans l'écran des courriels, ce traitement est soumis au
consentement une fois par session ; en fonctionnement en arrière-plan, il
s'exécute sans boîte de dialogue (l'activation du moniteur vaut consentement).
Pseudonymisé et audité dans les deux modes.
Aucun pixel de suivi. L'ouverture d'un courriel dans le moniteur ne
contacte jamais le serveur de l'expéditeur : les images référencées par une adresse
internet (y compris les pixels de suivi invisibles) ne sont pas chargées et
apparaissent sous forme de substituts (espaces réservés) accompagnés d'un avis, de
sorte que l'expéditeur ne peut savoir ni quand, ni combien de fois, ni depuis quelle
adresse un courriel a été lu. Seules les images intégrées dans le courriel lui-même
sont affichées.
4.3 Analyse de personnes (recherche web)
Trois étapes après un consentement donné une fois par session :
- Étape 1 — recherche : des moteurs locaux sont interrogés directement ; en
outre, l'outil de recherche web côté serveur du fournisseur est appelé avec le
nom réel de la personne en clair (inévitable pour une recherche ; journalisé
en clair).
- Étape 2 — résumés de pages (niveau moyen) : pour chaque page, le nom de la
personne (remplacé par un jeton), l'URL et le contenu de la page plafonné à 8 000
caractères.
- Étape 3 — synthèse du profil (grand niveau) : nom et ville (remplacés par
des jetons) plus chaque texte de page collecté, plafonné à 6 000 caractères par
source.
Le résultat est enregistré localement avec la fiabilité « non confirmé ». Les
boutons de remplissage automatique correspondants des formulaires
personne/institution envoient de même le nom saisi en clair (exception
documentée).
4.3a Vérification OSINT d'une partie (osint_entity)
La vérification OSINT d'une partie est une procédure fixe que l'application
exécute elle-même lorsqu'une IA connectée l'appelle avec le nom, la ville, le
district, le pays et la qualité de personne physique/morale :
- Dossiers : une recherche en texte intégral du nom dans la base de données
locale — purement locale, rien ne quitte la machine.
- Internet : une liste fixe de requêtes de recherche est envoyée aux moteurs
de recherche publics Google, DuckDuckGo et Qwant. Chaque requête se compose
d'un terme de recherche dans la langue du pays de la partie, plus le nom réel de
la partie en clair et, pour certaines requêtes, la ville ou le district
(inévitable pour une recherche). Aucun contenu de dossier, de client ou de document
n'est transmis. Les moteurs voient les requêtes comme celles de tout utilisateur d'un
navigateur.
- Gemini (uniquement s'il est configuré) : si l'utilisateur a configuré
Gemini via la connexion Google, exactement une invite est envoyée à Google —
la demande de trouver tout ce qui concerne la partie nommée originaire du pays
nommé —, contenant le nom réel et le pays en clair et rien d'autre.
Le résultat est renvoyé à l'IA appelante sous la forme d'un profil préparé et non
vérifié. Rien n'est inscrit dans les données de base : chaque constatation passe par
la barrière de validation du moniteur de données (section 4.5) et n'est reprise que
lorsque l'utilisateur l'accepte. Seules des sources accessibles au public sont
évaluées.
4.4 Journal quotidien
L'écran lui-même est local. L'importation de texte libre exécute d'abord un
analyseur local ; ce n'est que si aucun marqueur de format de journal n'est
trouvé qu'une solution de repli par IA normalise le texte brut : le texte collé est
envoyé intégralement (interruption au-delà de 200 000 caractères), petit niveau,
soumis au consentement, pseudonymisé, audité. Les journaux enregistrés ne quittent la
machine qu'en tant que résultats d'outils du chat/de la passerelle (extraits
plafonnés) ou au sein du paquet d'instructions IA (section 5).
4.5 Moniteur de données
La phase 1 (courriel ↔ données de base) est entièrement déterministe. La phase 2
envoie un appel de petit niveau (pseudonymisé, audité, sans boîte de dialogue,
limité aux nouveaux documents entrants) contenant : toutes les fiches de base
enregistrées des institutions et des personnes/entités du titulaire (ID, noms,
coordonnées, CNP — remplacés par des jetons lorsqu'ils figurent dans le dictionnaire ;
noms d'institutions en clair), tous les noms de parties issus des dossiers, et des
extraits de zones de coordonnées dédoublonnés (±~100 caractères autour des
marqueurs d'adresse/de téléphone/fiscaux) provenant des textes intégraux des
documents entrants, plafonnés à 130 000 caractères au total. La réponse ne devient
jamais qu'une suggestion que l'utilisateur doit accepter dans le moniteur.
4.6 Traitement de texte (assistance IA dans le texte)
- Réviser la sélection : la phrase/le paragraphe/la section sélectionné(e)
(avec balisage) plus les 6 000 premiers caractères de l'ensemble du document à
titre de contexte et l'instruction de l'utilisateur — niveau moyen,
pseudonymisé.
- Structure/table des matières : en pratique l'ensemble du document sous
forme de liste de lignes indexées (lignes courtes en entier, lignes longues tronquées
à 80 caractères), plafonné à 40 000 caractères — niveau moyen, pseudonymisé.
- Prétraitement de la lecture à voix haute : lors de la lecture à voix haute
d'un document, chaque phrase est envoyée individuellement en clair au petit
niveau afin de développer les abréviations et les nombres — sans
pseudonymisation (les numéros d'identification doivent revenir inchangés pour être
lus correctement). Les tampons de fichier et les marqueurs de référence sont d'abord
supprimés localement. Le lancement de la lecture à voix haute constitue le moment du
consentement.
Aucun des appels du traitement de texte n'affiche de boîte de
dialogue de consentement distincte ni n'inscrit de lignes dans le journal d'audit
(contournement du routeur, voir section 3).
4.7 Revue Red/Blue Team et résumé du dialogue (API)
Deux autres flux API relèvent de la rédaction. Red/Blue Team : si
l'utilisateur l'a activée pour le fournisseur actif (interrupteur à côté de la clé
API ; une clé enregistrée est requise), chaque document formel remis via
deliver_file — depuis le chat de l'application comme depuis la
passerelle d'IA de bureau — est relu une fois de plus par le même fournisseur dans le
rôle de l'avocat adverse (niveau moyen). Sont transmis : le texte du projet, la date
et la juridiction compétente du dossier ; pseudonymisé par le routeur et audité comme
tout appel du routeur ; aucune boîte de dialogue distincte — l'interrupteur vaut
consentement ; au plus deux tours par fichier, après le second tour le fichier est
remis dans tous les cas, accompagné du rapport du relecteur à l'attention de
l'utilisateur. Résumé du dialogue : lors de longues sessions de chat, la partie
la plus ancienne du dialogue (uniquement les questions de l'utilisateur et les
réponses finales du modèle, jamais les résultats d'outils) est condensée par le
fournisseur actif (petit niveau, en arrière-plan) en un résumé de 2 000 caractères
qui remplace l'historique brut ; il est stocké chiffré dans la mémoire de travail
temporaire et écrasé à chaque fois.
4.8 Chat IA (externe, API)
Consentement une fois par session de chat ; niveau moyen avec escalade automatique
vers le grand niveau (l'ensemble du contexte est alors renvoyé) ; pseudonymisé ;
chaque tour audité. Chaque échange transmet : l'invite système (règles statiques), le
contexte GUI en direct (écran actuel, dossier/client ouvert, y compris le nom
du client — remplacé par un jeton), jusqu'à 10 entrées de la mémoire IA du
client ouvert, le dialogue le plus récent plafonné à 6 000 caractères plus un résumé
de 2 000 caractères des échanges plus anciens (4.7) et la liste des fichiers de
travail temporaires du chat. Chaque outil appelé par le modèle renvoie son résultat
dans la conversation API — y compris les textes intégraux des documents (plafonnés à
10 000 caractères par élément ; les résultats plus volumineux sont écrits dans la
mémoire de travail temporaire chiffrée et lus par portions), les corps de courriels et
des extraits du journal quotidien. Depuis septembre 2026, le chat utilise la même
couche d'outils et les mêmes barrières de remise que la passerelle d'IA de bureau
(4.9) : vérification des actes de procédure, Red/Blue Team (4.7) et remise via la
boîte de dialogue d'exportation — ce qui quitte le système est un modèle prêt à être
déposé. La couche de chat locale répond aux demandes courantes sans aucune
transmission.
Deux outils de confort méritent une mention explicite. get_weather
récupère des données météorologiques actuelles pour un lieu nommé auprès du service
non-LLM Open-Meteo (section 7) — seuls le nom du lieu / ses coordonnées sont transmis
à ce service, jamais de données de dossier ou de personne. get_my_location
répond exclusivement à partir de l'instantané de sécurité le plus récent enregistré
localement (section 8) : la demande de l'IA ne déclenche aucune nouvelle
consultation externe — elle se contente de lire ce qui se trouve déjà sur le
disque. Comme pour tout outil, ce que ces outils renvoient est réinjecté dans la
conversation d'IA, c'est-à-dire transmis au fournisseur d'IA.
4.9 Passerelle vers une IA de bureau locale (Claude Desktop / Claude Code / ChatGPT
Desktop / Qwen Desktop / Kimi Desktop) — modules complémentaires FACULTATIFS
Chaque accès à une IA de bureau constitue un module facultatif, acquis
séparément. Il n'existe que si le cabinet a acquis et installé le module de
passerelle correspondant ; en l'absence de tout module, la section de la passerelle
reste verrouillée dans la configuration, le point de terminaison local ne démarre
jamais, et aucun des flux décrits dans la présente section ne peut avoir lieu. Le même
serveur MCP STDIO local peut être enregistré auprès de Claude Desktop/Claude
Code, de ChatGPT Desktop, de Qwen Desktop et/ou de Kimi Desktop — le fonctionnement
décrit ci-dessous est identique pour tous ; seul le fournisseur destinataire
diffère.
Ce canal transmet des données de dossier brutes, non
pseudonymisées. C'est sa finalité : la session d'IA de bureau propre de
l'utilisateur rédige des modèles prêts à être déposés et a donc besoin des noms et
numéros réels.
- L'IA de bureau (Claude Desktop/Code, ChatGPT Desktop, Qwen Desktop ou Kimi Desktop) se connecte
à l'application en cours d'exécution par l'intermédiaire d'une passerelle locale ;
le point de terminaison HTTP est lié exclusivement à 127.0.0.1 (localhost constitue la
limite d'accès ; le jeton enregistré n'est pas vérifié en sus).
- Lors du premier accès aux données par exécution du programme, IRONSTICK affiche
une fenêtre modale bloquante de consentement ; un refus bloque le canal pendant
10 minutes. Après approbation, le canal reste ouvert pour le reste de l'exécution du
programme.
- Plus de 170 outils — dont plus de 100 outils de lecture — donnent accès aux chroniques, textes intégraux,
courriels, journaux quotidiens, délais, données de base, dossiers complets (par
parties) et formats de sortie ; les documents marqués comme secrets sont exclus. Les
voies d'écriture sont soumises à une barrière de validation (les suggestions de
données de base/de relations aboutissent dans le moniteur de données ; les
modifications proposées par l'IA aux notes d'instructions IA liées à un dossier sont
présentées sous forme de différentiel rouge/vert dans IRONSTICK et ne sont appliquées
qu'après acceptation expresse de l'utilisateur — la décision est communiquée en retour
à l'IA) ou explicites (remise au traitement de texte, remise de fichiers, navigation
uniquement si elle est autorisée séparément). Le même schéma de barrière de validation
couvre les deux voies d'écriture plus récentes : les entrées de chronique ne sont
jamais écrites par l'IA — elle se contente de PRÉREMPLIR le formulaire de saisie, que
l'utilisateur complète et enregistre lui-même ; et un texte intégral de document
réparé par l'IA (nouvelle numérisation OCR, point suivant) ne remplace le texte
intégral enregistré qu'après que l'utilisateur a vu le texte complet dans une boîte de
dialogue de confirmation et l'a enregistré.
- Réparation par nouvelle numérisation OCR (locale) et remise du PDF (à
l'initiative de l'utilisateur). Lorsqu'un texte intégral enregistré est tronqué ou
altéré par une ancienne passe d'OCR, l'IA peut demander une nouvelle numérisation :
l'utilisateur choisit les pages, la nouvelle numérisation s'exécute localement
(aucun nouveau destinataire externe), et les deux versions du texte sont placées dans
l'espace de travail temporaire local ; tout ce que l'IA en lit est transmis à son
fournisseur comme tout autre résultat d'outil. En tout dernier recours — uniquement
après une telle nouvelle numérisation et uniquement dans des limites strictes imposées
par la passerelle (≤ 10 MB, ≤ 90 pages) —, l'IA peut demander à
l'utilisateur de lui remettre le fichier PDF original : IRONSTICK se contente
d'ouvrir l'entrée ; l'utilisateur enregistre lui-même le PDF au moyen de l'icône en
forme de trombone et le fait glisser dans le chat de l'IA de bureau. Le document est
ainsi transféré en tant que fichier (y compris les tampons, signatures et
images) au fournisseur de cette IA — cela se produit exclusivement par l'action propre
et délibérée de l'utilisateur, jamais automatiquement, et les documents marqués comme
secrets sont exclus d'emblée de l'ensemble du canal de nouvelle numérisation.
- Espace de travail temporaire local de l'IA (minimisation des données). Tout
appel d'outil peut rediriger son résultat complet vers un fichier de travail
temporaire local et éphémère (
to_scratch) ; l'IA ne reçoit alors que le
chemin du fichier plus un bref aperçu (≈1 200 caractères) au lieu du texte intégral.
Des outils d'édition locaux (rechercher/remplacer/insérer/différentiel/normaliser)
retravaillent ces fichiers sur la machine de l'utilisateur, et les outils de
remise/mise à jour les utilisent par leur chemin — des contenus volumineux peuvent
ainsi être acheminés et retravaillés sans être transmis au fournisseur d'IA.
Les extractions complètes de dossiers (dump_case_to_scratch) et le
protocole de démarrage de session en un seul appel sont de même écrits directement
dans cette zone locale ; seules les portions que l'IA lit ensuite sont transmises à
son fournisseur. IRONSTICK surveille en outre l'actualité de ces fichiers et les
invalide lorsque les données sous-jacentes changent. Le dossier de travail temporaire
se trouve dans le répertoire de données et subsiste d'une session à l'autre (il
constitue le contexte de travail de l'IA) ; les fichiers non utilisés sont purgés
après 180 jours, et aucun nouveau destinataire externe n'est créé.
- La mémoire de travail temporaire est un coffre-fort chiffré (depuis septembre
2026). Chaque fichier de la mémoire de travail temporaire est chiffré au repos en
AES-256, avec la même dérivation de clé que la base de données et le stockage des
documents. La lecture et l'écriture passent exclusivement par la barrière
d'IRONSTICK ; un fichier en clair déposé dans cette mémoire par toute autre voie (un
outil de système de fichiers de l'IA de bureau, une copie manuelle) est refusé,
supprimé et signalé à l'IA comme une violation des règles ; les fichiers ne quittent
cette mémoire que par la boîte de dialogue d'exportation d'IRONSTICK, jamais vers un
dossier de téléchargement. Conjointement avec la base de données, le stockage des
documents et le fichier de configuration chiffrés, cela comble la dernière lacune sur
la machine locale : aucune donnée de dossier ne se trouve non chiffrée sur le
disque de l'utilisateur — pas même les fichiers de travail de l'IA. Un disque
copié, une clé perdue ou une archive de sauvegarde tombée entre de mauvaises mains ne
livre que du texte chiffré.
- Les résultats des outils sont remis au client d'IA de bureau de l'utilisateur et,
de là, à son fournisseur : Anthropic pour Claude (dans le cadre de
l'abonnement Claude de l'utilisateur et des conditions d'Anthropic), OpenAI pour
ChatGPT (dans le cadre de l'abonnement ChatGPT de l'utilisateur et des conditions
d'OpenAI), Alibaba Cloud/Qwen pour Qwen Desktop (dans le cadre du compte Qwen de
l'utilisateur et des conditions de Qwen) ou Moonshot AI pour Kimi Desktop (dans le cadre
du compte Kimi de l'utilisateur et des conditions de Moonshot AI). IRONSTICK n'inscrit aucune ligne dans le
journal d'audit pour le trafic de la passerelle ; la barre supérieure affiche un logo
clignotant par IA active (marque Claude, marque ChatGPT, marque Qwen, marque Kimi) — un accès
simultané est possible et chacun est signalé séparément. La passerelle elle-même tient
un journal de diagnostic purement local de ses appels d'outils — horodatage,
nom de l'outil, succès/échec et taille de la réponse, jamais aucun contenu —
dans un fichier en clair situé à côté du programme de la passerelle. Ce journal n'est
transmis nulle part et sert uniquement au dépannage.
- La mémoire IA partagée enregistre localement des enseignements condensés
(≤1 000 caractères chacun, liés à un client/dossier, à expiration automatique) ; son
contenu est visible par chaque canal d'IA et est transmis chaque fois que ces canaux le
lisent.
- La relecture croisée entre les IA de bureau passe par IRONSTICK, et non
directement entre les fournisseurs : une IA dépose un produit de travail (par ex. un
projet) dans une mémoire tampon d'échange locale et de courte durée (fichiers
en clair sur la machine de l'utilisateur, supprimés à la clôture de la tâche et
effacés intégralement à chaque redémarrage de l'application) ainsi qu'une note de
tâche ; l'autre IA la lit lorsque l'utilisateur le lui demande. Cela ne crée aucun
nouveau destinataire externe — tout ce que lit l'IA relectrice est transmis à
son propre fournisseur exactement comme tout autre résultat d'outil ci-dessus,
dans le cadre des conditions de ce fournisseur. Aucun contenu ne passe jamais d'un
fournisseur à l'autre.
5. Le paquet d'instructions IA (ZIP d'exportation)
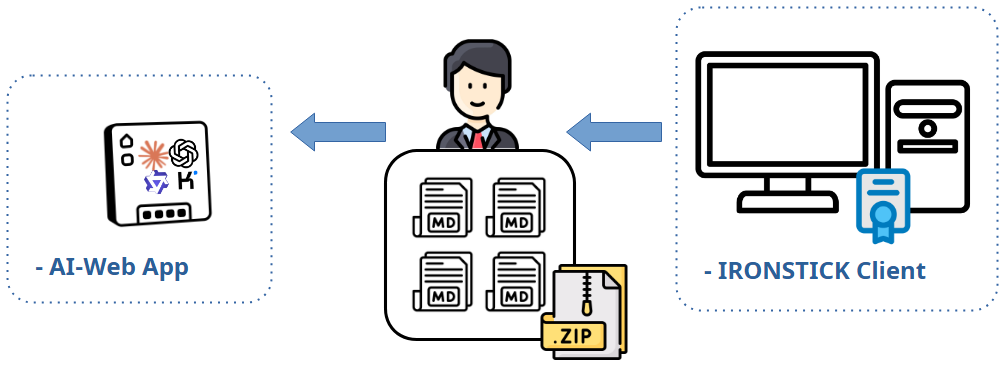
La constitution du paquet est locale et n'implique aucun appel d'IA. Elle produit du
Markdown en clair (sans pseudonymisation) destiné à être téléversé par
l'utilisateur vers un LLM externe de son choix. Contenu :
| Fichier | Contenu |
|---|
| Dossiers | tous les dossiers du client sélectionné avec les parties, le
statut et l'index des ID de pièces (sans textes intégraux) |
| Entités | toutes les personnes/entités de l'ensemble du cabinet
(et pas seulement de ce client), y compris CNP/CUI, date de naissance, coordonnées
complètes, profession, véhicule — plus les blocs d'analyse enregistrés (évaluation,
vulnérabilités, domiciles, finances, environnement social, sources) |
| Institutions, délais | toutes les institutions ; délais actifs avec
numéros de dossier et nom du client |
| Courrier | les 100 courriels les plus récents à l'échelle du
cabinet : expéditeur, destinataire, objet, noms des fichiers joints, extrait ≤500
caractères (sans corps complets) |
| Journal quotidien | 10 derniers jours, à l'échelle du cabinet, y compris
la chronologie des dossiers sur cette période |
| Par dossier | un dossier par affaire : la chronique complète avec les
textes intégraux des documents (budget ~170 KB par fichier, puis forme compacte),
identifiants du client et des parties, y compris le CNP ; plus toutes les notes de
contexte du dossier, sans plafond |
| Fichiers d'instructions | cinq documents de règles de travail — aucune donnée à caractère personnel |
Ce qui se produit lorsque ce ZIP est fourni à un LLM
tiers : l'utilisateur transfère personnellement, en clair, des parties
substantielles de l'ensemble du cabinet — identités des clients avec leurs numéros
d'identification nationaux, profils de tiers comprenant des évaluations sensibles,
métadonnées de correspondance à l'échelle du cabinet et dossiers — à ce fournisseur. À
partir de ce moment, les données sont traitées selon les conditions du fournisseur
tiers (utilisation pour l'entraînement, conservation, juridiction), entièrement en
dehors du contrôle d'IRONSTICK. IRONSTICK affiche un avertissement relatif à la
protection des données avant l'exportation (une fois par exécution du programme) et
propose également l'exportation vers Google Drive, ce qui place en outre les fichiers
chez Google. L'utilisateur agit en tant que responsable du traitement transmetteur au
sens du RGPD et doit s'assurer de l'existence d'une base juridique (par ex. art. 6,
règles relatives au secret professionnel) avant le téléversement.
Les documents marqués comme secrets sont exclus des délais, des journaux quotidiens
et des dossiers d'affaires.
6. Matrice récapitulative
| Flux | Ce qui sort (forme) | Pseudonymisé | Boîte de dialogue de consentement propre | Journal d'audit |
|---|
| Saisie de documents (4 appels) | texte OCR/du document ≤30k, listes de dossiers/de noms | oui | oui — une fois par exécution du programme | oui |
| Tri des courriels (écran) | Expéditeur/Objet/Extrait ≤1,5k + liste des dossiers | oui | oui — une fois par session | oui |
| Tri des courriels (arrière-plan) | idem | oui | non (interrupteur du moniteur = consentement) | oui |
| Recherche de personnes, ét. 1 | nom réel (recherche web) | non — par conception | oui — une fois par session | oui (en clair) |
| Recherche de personnes, ét. 2/3 | textes de pages ≤8k / ≤6k par source | oui | même consentement | oui |
| Remplissage automatique personne/institution | nom saisi (recherche web) | non — par conception | oui — une fois par session | oui (en clair) |
| Importation IA du journal quotidien | texte brut collé ≤200k | oui | oui | oui |
| Moniteur de données | fiches de base + zones de coordonnées ≤130k | oui (noms d'instit. en clair) | non (arrière-plan limité) | oui |
| Traitement de texte : réviser / structurer | sélection + contexte de 6k / lignes du doc. ≤40k | oui | non (bouton = consentement) | non |
| Prétraitement de la lecture à voix haute | chaque phrase, en clair | non | non (lancement = consentement) | non |
| Revue Red/Blue Team (API) | texte du projet + date + juridiction, par tour (max. 2) | oui | non (interrupteur = consentement) | oui |
| Résumé du dialogue (API) | échanges plus anciens du dialogue (utilisateur/assistant uniquement) | oui | non (compris dans le consentement au chat) | oui |
| Correction par IA File→Markdown | texte converti | oui | non | non |
| Outil d'IA de repérage pour le caviardage | texte déjà caviardé ; les réponses contiennent des noms en clair de tiers | désactivée — par conception | interrupteur = consentement | oui |
| Chat IA (externe) | invite + contexte GUI + mémoire + fin de dialogue de 6k + résumé de 2k + résultats d'outils ≤10k/élément | oui | oui — une fois par session | oui |
| Passerelle d'IA de bureau (Claude Desktop/Code, ChatGPT Desktop, Qwen Desktop, Kimi Desktop) | résultats d'outils bruts (données de dossier complètes) | non — par conception | oui — une fois par exécution du programme, blocage de 10 min en cas de refus | non (côté application) |
| ZIP d'instructions IA | exportation en clair du cabinet (téléversement à l'initiative de l'utilisateur) | non | avertissement une fois par exécution du programme | s.o. |
7. Services externes non-LLM (par souci d'exhaustivité)
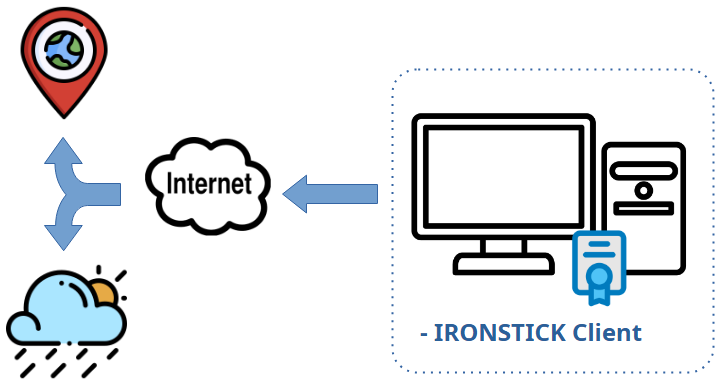
Indépendamment de tout LLM, les fonctionnalités suivantes contactent des services
externes avec le minimum de données nécessaires : validation de numéros (EU VIES,
EORI, GLEIF, registres du commerce — le numéro vérifié), géocodage d'adresses
(OpenStreetMap Nominatim — l'adresse), les requêtes web directes de la recherche de
personnes (le nom), IMAP (votre serveur de messagerie), et
les exportations facultatives vers Google Drive (les fichiers exportés). Aucun de ces
services n'implique le fournisseur d'IA.
Deux autres services reçoivent des données tout aussi minimales :
- ipwho.is (géolocalisation IP) — une fois par démarrage du programme, dans
le cadre de l'instantané de sécurité local (section 8), IRONSTICK demande à ce service
l'adresse IP publique de la machine et une localisation approximative (ville,
pays, FAI). La requête HTTPS sortante ne contient aucune donnée à caractère
personnel de quelque nature que ce soit — comme tout serveur web, le service ne
voit que l'adresse IP d'où provient la requête. La réponse est enregistrée
exclusivement en local et n'est transmise nulle part ailleurs.
- Open-Meteo (météo) — sur demande, l'outil météo de l'IA
(
get_weather, section 4.8) interroge les données météorologiques actuelles
pour un lieu nommé. Seuls le nom du lieu / ses coordonnées sont transmis — jamais de
données de dossier, de client ou de personne.
Aucun de ces services n'implique le fournisseur d'IA.
8. Stockage local, intégrité et maîtrise par l'utilisateur
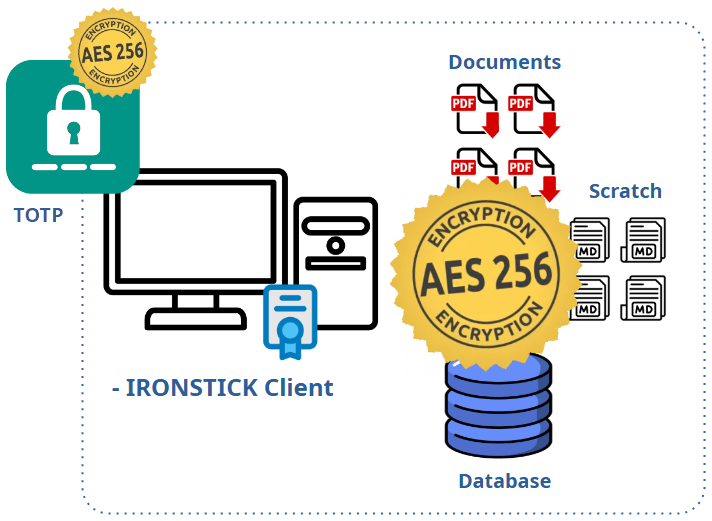
Indépendamment des canaux d'IA ci-dessus, ce qui suit s'applique à toutes
les données détenues par IRONSTICK :
- Stockage exclusivement local. L'ensemble des données — base de données,
fichiers de documents, médias, transcriptions, configuration — se trouve dans un
répertoire de données unique, à un emplacement défini par l'utilisateur. IRONSTICK ne
requiert aucun compte cloud et n'exploite aucun serveur ; l'éditeur ne détient jamais
de copie d'aucune donnée de l'utilisateur. Lorsqu'un cabinet exploite le serveur
facultatif IRONSTICK SERVER (section 9), ce serveur est lui aussi l'appareil propre du
cabinet, sur le réseau propre du cabinet — rien ne change quant à l'accès de
l'éditeur.
- Base de données chiffrée au repos (AES-256). La base de données — le
registre des clients, dossiers, chroniques, courriels, délais, textes des
transcriptions et la mémoire des IA — est stockée chiffrée en AES-256, chaque page
individuellement et avec un sceau d'intégrité par page. La clé est dérivée par
l'application au moment de l'exécution et n'est jamais écrite sur le disque ni dans la
configuration, de sorte qu'un fichier de base de données obtenu à partir du support ou
d'une archive de sauvegarde ne livre rien sans IRONSTICK. Il s'agit d'une mesure
technique au sens de l'art. 32 du RGPD, qui s'applique sans aucune configuration par
l'utilisateur et ne peut pas être désactivée.
- Documents chiffrés au repos (AES-256). Le stockage des documents — les PDF
originaux, numérisations, images, fichiers audio et de transcription — est chiffré de
la même manière, fichier par fichier, avec un sceau d'intégrité qui détecte toute
altération. La lecture passe par une barrière unique qui déchiffre le fichier demandé
dans une copie de travail temporaire et supprime ces copies à la fermeture ou au
démarrage de l'application. Les sauvegardes et les paquets de dossiers contiennent les
documents sous leur forme chiffrée. Limites, exposées clairement : les copies de
travail de la session en cours sont en clair dans le dossier temporaire (sous Android,
ce dossier se trouve dans le stockage partagé) ; les exportations et les courriels
sortants sont en clair par conception ; et le chiffrement protège contre la lecture du
support en dehors d'IRONSTICK, non contre un utilisateur autorisé de
l'application.
- Contrôle d'accès au démarrage (TOTP). Une fois la clé de licence acceptée,
l'application n'affiche rien d'autre qu'une invite de saisie de code jusqu'à ce que
l'utilisateur saisisse le code à usage unique actuel à six chiffres, basé sur le
temps, provenant d'une application d'authentification (RFC 6238). Le secret à
l'origine des codes est dérivé de la clé de licence au moment de l'exécution et n'est
jamais écrit sur le disque ; seule une empreinte non secrète de la configuration
confirmée est enregistrée, afin que le code QR soit de nouveau affiché après un
changement de clé. Des codes erronés répétés déclenchent un délai d'attente croissant.
Les passerelles d'IA de bureau ne reçoivent aucune donnée de dossier tant que
l'application est verrouillée. La récupération s'effectue au moyen de la clé de
licence, ce qui fait de la clé de licence l'identifiant maître de l'installation — sa
garde relève de la responsabilité de l'exploitant. Le fichier de configuration (clés
API, identifiants de messagerie, accès au serveur) est stocké chiffré en AES-256 selon
le même mécanisme que les documents et n'est déchiffré qu'en mémoire.
- Emplacement de stockage choisi par l'utilisateur. Le chemin des données est
choisi lors de l'installation et peut être modifié à tout moment — y compris vers un
support amovible tel qu'une clé USB chiffrée ou un disque externe chiffré.
L'application suit simplement l'emplacement configuré ; le chiffrement du support (par
ex. au moyen du chiffrement de disque du système d'exploitation) relève de
l'utilisateur et est recommandé pour les supports portables. Une conséquence à peser
délibérément : si le répertoire de données choisi se trouve dans un dossier
synchronisé avec le cloud (par ex. Google Drive), l'ensemble des données, y compris
le fichier de configuration contenant la clé d'accès à l'IA et les identifiants de
messagerie, est synchronisé avec ce fournisseur cloud selon les conditions propres
à ce fournisseur — placer le répertoire de données à cet endroit relève de la décision
et de la responsabilité de l'utilisateur.
- Synchronisation des appareils sans aucun cloud. La synchronisation
facultative Windows ↔ tablette Android s'effectue par une connexion directe
par câble USB — aucun service tiers n'intervient, les transferts sont vérifiés par
somme de contrôle, et une sauvegarde obligatoire est effectuée avant le remplacement
de la base de données. Les documents marqués comme secrets ne sont jamais transférés
vers la tablette.
- Instantané de sécurité au démarrage (journal de connexion local). À chaque
démarrage du programme, IRONSTICK enregistre en arrière-plan un instantané de la
machine sur laquelle il s'exécute : nom d'hôte, système d'exploitation, RAM/CPU,
adresse IP locale, navigateur par défaut, outils d'accès à distance en cours
d'exécution qu'il détecte, et un score de sécurité dérivé — plus, une fois par
démarrage, l'adresse IP publique et la localisation approximative (ville, pays, FAI)
obtenues auprès du service de géolocalisation IP ipwho.is (section 7).
L'instantané est enregistré exclusivement en local dans la base de données
(table
T9_LoginLog) et n'est transmis nulle part. La conservation est
limitée automatiquement à 6 mois au maximum et à 1 000 entrées au
maximum (maintenance quotidienne), et l'utilisateur peut consulter le journal à tout
moment dans le configurateur (carte «Journal de connexion»).
- Empreintes d'intégrité sur chaque fichier saisi. Au moment de la saisie,
chaque fichier enregistré reçoit une empreinte cryptographique de son contenu (SHA-256
pour les documents et les médias ; une empreinte MD5 héritée pour les fichiers audio
de transcription), consignée dans la base de données à côté de l'entrée. Toute
modification ultérieure d'un fichier enregistré est donc détectable par
comparaison du fichier avec son empreinte consignée, et les exportations
d'e-discovery (EDRM) contiennent ces empreintes afin que les destinataires puissent
vérifier les fichiers de manière indépendante. La manipulation devient ainsi
manifeste ; comme tout mécanisme d'empreinte, il n'empêche pas physiquement la
modification des fichiers sur le disque — il la rend démontrable.
- Sauvegardes à la discrétion de l'utilisateur. Une fonction de sauvegarde
intégrée écrit une copie complète des données (sauvegarde complète ou sauvegarde des
seules données) sous la forme d'une archive ZIP unique vers toute destination choisie
par l'utilisateur, et effectue la restauration à partir d'une telle archive sur
demande. La fréquence des sauvegardes, leur lieu de conservation, leur durée de
conservation et le chiffrement supplémentaire éventuel des archives relèvent
entièrement de la décision de l'utilisateur (la base de données et les fichiers de
documents contenus dans chaque archive sont en tout état de cause chiffrés en
AES-256) —
IRONSTICK n'impose aucun calendrier et ne transmet les sauvegardes nulle part.
- Les documents générés appartiennent à l'utilisateur. L'utilisateur peut
générer des documents à tout moment — actes de procédure, courriers, dossiers, listes,
exportations — et les télécharger : ils sont écrits dans le dossier Documents local
ou, lorsque l'utilisateur a placé le répertoire de données dans un dossier Google
Drive ou choisit expressément Google Drive comme destination, dans le compte Google
Drive propre de l'utilisateur.
Le rôle d'IRONSTICK prend fin avec la production du fichier. Tout ce qu'il
advient ensuite d'un document généré — impression, dépôt auprès d'une juridiction,
envoi par courriel, téléversement vers un service quelconque, communication à des
tiers — est effectué par l'utilisateur et relève exclusivement de sa
responsabilité.
Répartition des responsabilités. Dès lors qu'IRONSTICK stocke
tout localement et ne transmet des données que par les voies documentées aux sections
1 à 7 — chacune d'elles étant soit pseudonymisée, soit soumise au consentement, soit
déclenchée par une action délibérée de l'utilisateur —, l'exploitant du cabinet est le
seul responsable du traitement : il choisit le support de stockage et son chiffrement,
gère et conserve les sauvegardes, décide des fonctions d'IA activées, donne ou refuse
chaque consentement, et décide seul de ce qu'il advient de chaque document,
exportation ou sauvegarde produit par le logiciel. Le contenu généré par l'IA —
projets, résumés, évaluations, classifications — constitue toujours une
proposition que l'utilisateur doit examiner professionnellement avant de s'y
fier ou de l'expédier. Le présent document existe afin que chacune de ces décisions
puisse être prise en pleine connaissance des flux de données réels.
9. Le serveur LAN du cabinet, facultatif (IRONSTICK SERVER)
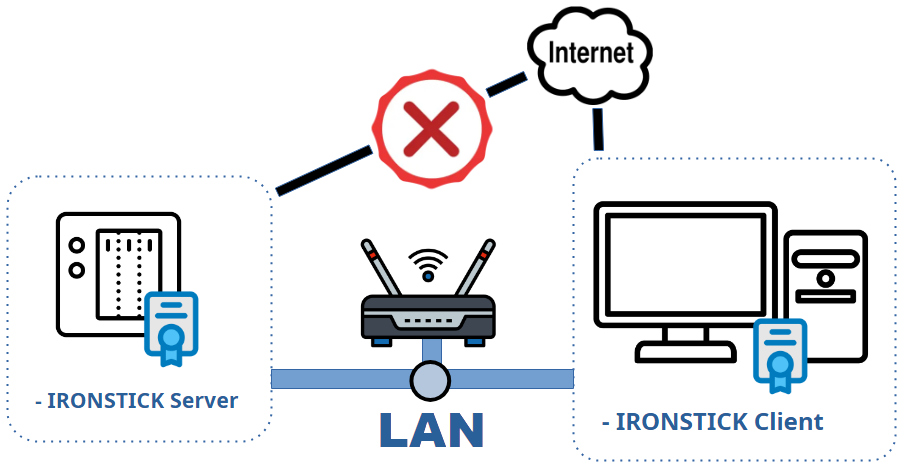
Les cabinets disposant de plusieurs postes de travail IRONSTICK peuvent exploiter le
serveur facultatif IRONSTICK SERVER — un service de coordination qui s'exécute
sur le NAS Synology propre du cabinet, au sein du réseau local propre du cabinet. Aux
fins de la présente déclaration, les faits déterminants sont les suivants :
- Aucune partie externe n'intervient. Le serveur est l'appareil propre du
cabinet. Il n'accepte de connexions qu'à partir d'adresses réseau privées (locales) et
n'initie jamais aucune connexion vers internet — ni télémétrie, ni vérification
de mises à jour, ni contact avec l'éditeur. L'éditeur du logiciel n'a aucun accès de
quelque nature que ce soit.
- Aucune intervention d'IA. Le serveur n'achemine aucun trafic d'IA, ne
stocke aucune clé d'IA et ne communique jamais avec un quelconque fournisseur de
modèles de langage. Tous les canaux d'IA décrits aux sections 1 à 6 restent
strictement propres à chaque poste de travail ; la couche de pseudonymisation, les
barrières de consentement et le journal d'audit ne sont pas affectés par la présence
du serveur.
- Ce que le serveur stocke — l'ensemble sur le NAS, sous le contrôle du
cabinet : (a) les paquets de dossiers partagés — uniquement les dossiers qu'un
utilisateur a expressément mis à la disposition de ses collègues ; les documents
marqués comme secrets sont exclus par conception et ne parviennent jamais au serveur ;
(b) la bibliothèque juridique centrale — textes législatifs publics au format
Markdown, chacun accompagné du nom de l'utilisateur contributeur, du lien vers la
source et de la date de vérification ; (c) les enregistrements du suivi du
temps — par utilisateur, jour et dossier : numéro de dossier, nom du client et
minutes, communiqués en arrière-plan par chaque poste de travail ; (d) les totaux
de présence par utilisateur et par jour, dérivés des signaux de présence de
session ; (e) les métadonnées d'événements de dossier — partages, révocations,
débuts/fins d'abonnement et exportations, chacun avec la date, l'heure et l'adresse IP
LAN ; (f) un journal de sécurité comprenant les événements d'administration et
de connexion, y compris les adresses IP LAN ; (g) les colis de transmission de
dossiers — lorsqu'un utilisateur transfère la titularité d'un dossier à un
collègue, le dossier complet transite sous forme d'une archive unique par une zone
d'attente du serveur (« spool ») ; le colis est supprimé du serveur après que le
destinataire a confirmé l'importation, et les documents marqués comme secrets ne sont
transmis qu'après une confirmation supplémentaire expresse du titulaire (à défaut, le
transfert est interrompu) ; (h) la réception centrale des numérisations
(Central Scan App facultative) : un registre des numéros de dossier et du nom
d'affichage de chaque utilisateur (communiqués par les postes de travail à titre
d'éléments de correspondance — jamais le contenu des dossiers) et une file
d'attente de documents par fichier, conservant le courrier entrant numérisé
adressé à un utilisateur jusqu'à ce que le poste de travail de cet utilisateur l'ait
récupéré et confirmé, après quoi la copie sur le serveur est supprimée ; la
reconnaissance de texte et l'attribution au destinataire s'effectuent localement sur
le poste de numérisation, sans aucune IA ; (i) les enregistrements d'événements de
sauvegarde — chaque poste de travail communique ses événements de sauvegarde et de
restauration des données (type, nom de fichier, taille, heure, IP LAN), de sorte que
l'administrateur peut voir pour chaque utilisateur quand la dernière sauvegarde a été
effectuée et relancer les utilisateurs en retard ; (j) le répertoire des parties à
l'échelle du cabinet (« réseau d'entités ») — les fiches de base des
personnes et sociétés, des institutions, des relations entre elles et des analyses
de personnes tenues par les postes de travail, ainsi que la file des propositions
de modification échangées entre utilisateurs. Voir le point suivant.
- Le répertoire des parties à l'échelle du cabinet. Dès qu'un poste de
travail est connecté au serveur, ses données de base relatives aux parties (qui est
qui : noms, identifiants, coordonnées, relations, analyse de personnes) sont
téléversées automatiquement et répliquées sur chaque autre poste de travail du
même cabinet, afin que chaque avocat voie avec qui le cabinet est déjà en relation et
que le cabinet dispose d'une vue d'ensemble des conflits d'intérêts. Chaque fiche a
exactement un titulaire — l'utilisateur qui l'a introduite en premier ; tous les
autres utilisateurs détiennent une copie en lecture seule et ne peuvent qu'envoyer une
proposition de modification, que le titulaire accepte ou rejette dans le
moniteur de données. Si le titulaire ne peut être joint pendant 48 heures, la
titularité passe à l'utilisateur ayant fait la proposition. Le contenu des dossiers
ne fait pas partie de ce répertoire — les documents, la chronologie, la
correspondance et les affectations de dossiers restent régis par les actions
explicites de partage et de transmission décrites ici. L'échange reste au sein du
cabinet (un seul responsable du traitement), ne quitte jamais le réseau local et
n'implique aucun fournisseur d'IA : la détection des doublons et la comparaison
des champs s'exécutent sous forme de simple logique de programme sur le poste de
travail émetteur ; le serveur se contente de stocker et de retransmettre. Les cabinets
devraient mentionner ce partage interne des données relatives aux parties et des
analyses de personnes dans leur registre des activités de traitement.
- Uniquement des actions délibérées — pour le contenu des dossiers. Le
contenu des dossiers ne parvient au serveur que par une action explicite de partage ou
de transmission confirmée par l'utilisateur ; les textes de la bibliothèque juridique
uniquement après que l'utilisateur a accepté l'entrée dans le moniteur de données ; le
courrier entrant numérisé uniquement après que l'employé de bureau a examiné le
document et cliqué sur l'envoi à un destinataire choisi. Le répertoire des parties
ci-dessus constitue l'unique exception délibérée : il se synchronise en arrière-plan
sans confirmation fiche par fiche. Les enregistrements de temps, de présence,
d'événements et de sauvegarde sont des métadonnées opérationnelles créées par le
fonctionnement multi-utilisateurs lui-même et sont visibles par l'administrateur du
cabinet dans l'interface d'administration web.
- Responsabilité du traitement. Le cabinet qui exploite le serveur demeure le
seul responsable du traitement. L'administrateur contrôle l'approbation des
inscriptions, peut mettre fin aux abonnements, supprimer des entrées de la
bibliothèque juridique et désinstaller le paquet — ce qui laisse le répertoire de
données du serveur sous le contrôle de l'administrateur sur le NAS.
- Noms complets des clients dans les enregistrements de temps. La vue
d'ensemble du suivi du temps affiche le temps de travail par dossier et par client, ce
qui signifie que des noms de clients sont stockés sur le NAS. Ces données restent au
sein de l'infrastructure propre du cabinet et de son régime de confidentialité
existant — mais les cabinets devraient inclure le NAS dans leur inventaire des mesures
techniques et organisationnelles (contrôle d'accès sur DSM, chiffrement du volume,
politique de sauvegarde), exactement comme ils le feraient pour tout serveur de
fichiers de bureau.
Annexe — Clause type pour votre notice d'information des clients (proposition)
Le texte suivant est une proposition de rédaction qu'un cabinet utilisant IRONSTICK
peut reprendre dans sa propre notice d'information des clients. Il est rédigé de
manière à correspondre exactement aux flux de données décrits ci-dessus — il ne promet
pas davantage de protection que celle effectivement assurée par le logiciel. Il évite
délibérément toute citation d'articles de loi afin de pouvoir être inséré dans des
notices de toute structure.
Avant d'insérer ce texte — liste de vérification pour
l'avocat :
- Assurez-vous de disposer du contrat de sous-traitance de chaque fournisseur
d'IA que vous avez configuré, ne nommez dans la clause que les fournisseurs que vous
utilisez effectivement, et vérifiez la phrase relative à l'entraînement et à la
conservation au regard des conditions que vous avez effectivement signées. La clause
ci-dessous ne couvre pas Gemini via un compte Google (service grand public
dépourvu d'un tel contrat, section 1) — si vous configurez cette voie, elle nécessite
une formulation propre et, en règle générale, le consentement exprès du client.
- Ne conservez la phrase entre crochets relative à l'espace de travail de l'IA que si
vous utilisez réellement la passerelle d'IA de bureau (Claude Desktop/Code, ChatGPT
Desktop, Qwen Desktop ou Kimi Desktop) ; supprimez-la dans le cas contraire.
- La présente clause couvre les flux au sein de l'application décrits dans le
présent document. Elle ne couvre pas le paquet d'instructions IA (section 5) —
le téléversement de cette exportation vers un service d'IA quelconque constitue une
décision distincte et requerra en règle générale le consentement exprès du
client.
- Si vous avez désactivé certaines fonctions d'IA dans le configurateur, raccourcissez
la liste des finalités en conséquence — décrivez exactement ce que vous utilisez, rien
de plus.
- Il s'agit d'une proposition de rédaction et non d'un conseil juridique. Faites-la
examiner au regard des règles professionnelles de votre barreau et de la pratique
locale en matière de protection des données avant toute utilisation.
Français
Traitement des dossiers assisté par IA. Notre cabinet utilise le
logiciel de gestion de dossiers IRONSTICK, qui comprend des fonctions assistées
par intelligence artificielle. Pour ces fonctions, certaines données de votre
dossier peuvent être transmises à un prestataire externe de services d'IA
(selon la disponibilité : Alibaba Cloud, Moonshot AI, OpenAI ou Anthropic, via leurs interfaces de programmation), qui les traite
pour notre compte dans le cadre d'un accord de sous-traitance. Nous utilisons
ces fonctions pour : le classement et l'enregistrement des documents entrants,
la priorisation du courrier électronique entrant, la vérification de la
cohérence de nos données, la rédaction et la relecture d'actes juridiques,
ainsi que l'analyse et la recherche juridiques.
Mesures de protection. Avant toute transmission, le logiciel
remplace, sur notre propre ordinateur, les identifiants directs enregistrés
dans notre système — noms, numéros d'identification personnels, numéros de
téléphone, adresses électroniques, adresses postales, numéros de dossier et
coordonnées bancaires — par des marqueurs neutres. La table de correspondance
entre marqueurs et données réelles ne quitte jamais le cabinet ; les réponses
du prestataire sont retraduites localement. Seul est transmis ce qui est
nécessaire à la fonction concernée, dans des limites de volume fixes. Quelques
fonctions exigent techniquement des données réelles — par exemple la recherche
publique sur Internet concernant le nom d'une personne, ou la fonction de
lecture à voix haute ; nous ne les utilisons que par une action individuelle
délibérée. [Optionnel — à supprimer si non utilisé : Pour la rédaction d'actes
de procédure, nous utilisons en outre un espace de travail IA dans lequel les
données du dossier sont traitées sans remplacement par des marqueurs ; ce canal
n'est utilisé que sous notre surveillance directe.]
Le prestataire. Selon les conditions du prestataire qui nous sont
applicables, les contenus transmis par l'interface de programmation ne sont pas
utilisés pour entraîner des modèles d'IA et ne sont conservés que pour une
durée limitée. Le traitement peut avoir lieu en dehors de l'Espace économique
européen ; dans ce cas, le transfert est protégé par les garanties convenues
dans notre accord de sous-traitance. Ce que le prestataire peut faire des
données est régi par cet accord — et non par la libre appréciation de l'IA.
Votre choix. Notre secret professionnel demeure intact : au-delà de
ce qui est décrit ici, aucune donnée ne quitte le cabinet. Le traitement repose
sur le mandat que vous nous avez confié et sur notre intérêt légitime à une
gestion efficace et rigoureuse de votre dossier. Vous pouvez vous opposer à
tout moment à l'utilisation des fonctions assistées par IA ; dans la mesure du
possible, nous traiterons alors votre dossier sans elles. Vous conservez par
ailleurs l'ensemble de vos droits en matière de protection des données :
accès, rectification, effacement et réclamation auprès de l'autorité de
contrôle.
La présente déclaration a été établie à partir du code source de
l'application (pseudonymiseur, routeur externe, journal d'audit et voie de
transmission de chaque fonctionnalité) et reflète le comportement livré de la version
décrite. Le traitement par le fournisseur d'IA lui-même — conservation, utilisation
pour l'entraînement, sous-traitants ultérieurs, juridiction — est régi exclusivement
par les conditions du fournisseur — les liens vers les conditions et la politique de
confidentialité de chaque fournisseur figurent dans la section correspondante de la
configuration de l'IA (Google Antigravity : antigravity.google/terms ; Alibaba Cloud :
alibabacloud.com/help/en/legal ; Moonshot AI : platform.kimi.ai/docs/agreement ;
OpenAI : openai.com/policies). Pour les services d'Anthropic, veuillez consulter, dans
leurs versions en vigueur : les Commercial Terms of Service
(anthropic.com/legal/commercial-terms),
la Usage Policy
(anthropic.com/legal/aup) et
la Privacy Policy
(anthropic.com/legal/privacy).
 IRONSTICK← Accueil